Cloudflare가 2026년 7월 공개한 보고서에서 자사 네트워크의 비인간 트래픽이 처음 50%를 넘었습니다. 2026년 6월 크롤러 요청의 52%는 AI 학습 목적이었고, 검색·에이전트·학습이 섞인 요청도 36% 이상이었습니다.
이 숫자가 곧 ‘우리 회사 방문자의 절반이 봇’이라는 뜻은 아닙니다. Cloudflare가 전 세계 웹의 20% 이상을 서비스하는 큰 표본이기는 해도 네트워크 전체 집계와 개별 사이트의 로그는 다릅니다. 중소기업의 첫 작업은 자체 로그 확인과 자료별 공개 목적 정리입니다.
크롤은 늘고 방문은 따라오지 않는다
검색엔진은 페이지를 수집한 뒤 결과 화면에서 원문 링크를 제공해 왔습니다. AI 서비스는 여러 문서를 가져와 답변 안에서 내용을 조합합니다. 답변으로 용도가 끝나면 원문 방문은 생기지 않습니다.
Cloudflare가 2025년 6월 19일부터 26일까지 측정한 크롤 요청과 리퍼럴 방문의 비율은 사업자별로 0.1대 1부터 70,900대 1까지 벌어졌습니다. 가장 높은 사례에서는 HTML 페이지를 약 7만 번 요청할 때 리퍼럴 한 번이 관측됐습니다.
네이티브 앱이 Referer 헤더를 남기지 않으면 실제 방문보다 적게 집계될 수 있고, 사업자별 비율도 시점에 따라 바뀝니다. 70,900대 1은 모든 AI 서비스에 적용할 평균이 아닙니다. 그럼에도 크롤 증가가 방문 증가를 뜻하지 않는다는 사실은 선명합니다.
Cloudflare는 크롤이 집중된 일부 범주에서 1년이 안 되는 기간에 사람 트래픽이 최대 40% 줄었다고 보고했습니다. 생성형 AI 이용자 25억 명, 정보 탐색 한 시간 중 열린 웹에 머무는 시간 15분이라는 수치도 함께 제시했습니다. 모두 Cloudflare의 네트워크·시장 관측치입니다. 개별 사이트의 감소율은 자체 로그에서 찾아야 합니다.
작은 회사에는 운영비와 공개 기준이 남는다
Cloudflare 집계에는 2023년 이후 퍼블리셔와 AI 기업이 맺은 라이선스 계약이 50건 넘게 등장합니다. 콘텐츠 자체를 판매하는 대형 퍼블리셔에는 수집 통제와 사용료가 직접적인 매출 문제입니다. 일반 기업 사이트는 사정이 다릅니다. 제품 설명과 전문 콘텐츠가 회사의 신뢰를 증명하면서 동시에 경쟁사가 가져갈 수 있는 자산이기도 합니다.
이 갈등은 거창한 정책보다 일상적인 운영에서 먼저 드러납니다. 봇 요청이 늘면 캐시와 대역폭을 점검해야 하고, 방문 통계에서는 사람과 자동 요청을 분리해야 합니다. 서버 비용이 실제로 늘었는지는 요청량과 청구 내역을 함께 봐야 알 수 있습니다. 봇이 많다는 보도만으로 비용 상승을 전제하면 엉뚱한 문제를 고치게 됩니다.
GEO와 SEO의 관계에서 다룬 것처럼 발견 가능성은 크롤 허용 하나로 결정되지 않습니다. 회사명과 제품명이 분명한 원문, 기준일이 붙은 수치, 오래 유지되는 URL이 함께 있어야 외부 답변을 다시 확인할 수 있습니다.
자료를 세 구역으로 나눈다
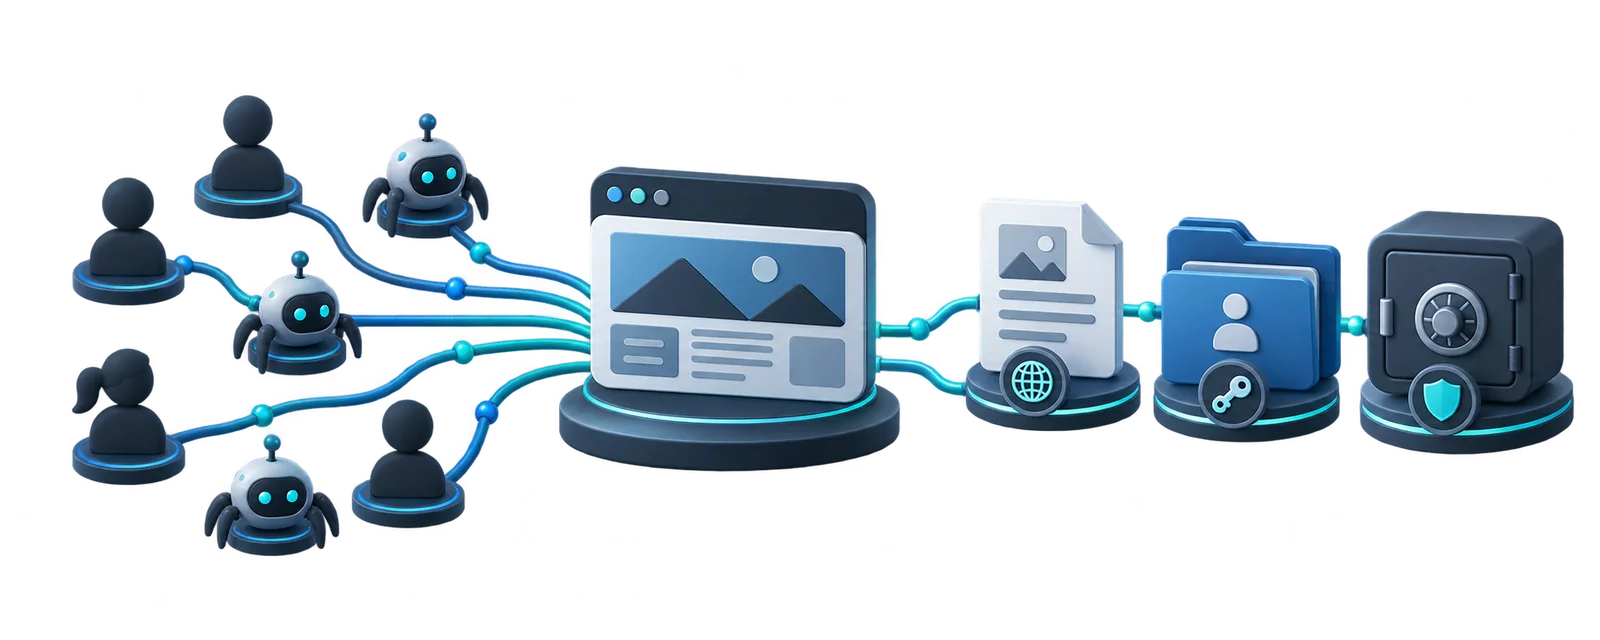
공개 구역에는 회사의 공식 제품 정보, 관점, 방법론과 출처가 확인되는 설명을 둡니다. 검색 결과나 AI 답변에서 회사를 처음 접한 사람이 사실을 확인할 자료입니다. 날짜가 지난 수치와 제품 정보는 담당자를 정해 갱신해야 합니다.
등록 구역은 연락처나 고객 관계가 생긴 뒤 제공할 자료입니다. 상세 벤치마크, 템플릿, 진단 도구처럼 유용하지만 누구나 대량 수집하도록 둘 필요는 없는 내용이 여기에 속합니다.
비공개 구역은 고객 데이터, 계약 조건, 단가표와 실제 구현 산출물입니다. robots.txt로 막기 전에 웹 서버에 두지 않는 편이 안전합니다. 접근 제어가 필요한 문서를 공개 URL에 올리고 크롤러 규칙에만 의존해서는 안 됩니다.
이 분류를 먼저 하면 허용과 차단을 한 줄짜리 신념으로 다루지 않게 됩니다. 공개 문서는 발견과 검증을 위해 열고, 등록 자료는 관계가 생긴 뒤 전달하며, 핵심 자산은 애초에 공개 경로에서 뺍니다. 검색과 학습 등 여러 목적으로 쓰이는 크롤러가 36%를 넘었다는 관측도 봇 이름만으로 목적을 완벽히 가르기 어렵다는 점을 보여줍니다.
로그 30일치로 첫 결정을 내린다
최근 30일의 서버 또는 CDN 로그에서 주요 봇이 어느 경로를 얼마나 요청했는지 뽑아봅니다. 요청이 많은 상위 경로를 세 구역에 대입하면 분류가 잘못된 문서가 먼저 보입니다. 공개 문서라면 크롤 이후 브랜드 검색이나 문의가 남았는지 살피고, 등록·비공개 자료가 노출됐다면 접근 방식부터 바로잡습니다.
허용 정책을 바꿀 때는 날짜와 대상 봇, 대상 경로를 기록해야 합니다. 이후 30일 동안 요청량, 검색 노출, AI 리퍼럴, 문의 품질을 같은 방식으로 비교합니다. 도구를 먼저 사는 것보다 이 기록 한 장이 차단 범위를 정하는 데 더 직접적인 근거가 됩니다.
방문이 줄어드는 환경에서 웹사이트는 회사가 말한 내용을 확인하는 원본 저장소 역할도 맡습니다. AI 생산성 역설과 업무 재설계에서 도구 도입보다 업무 정의를 먼저 다룬 이유도 같습니다. 공개 구역의 근거를 유지하고, 등록 구역의 가치를 지키며, 비공개 구역을 웹에서 치우는 것. AI 크롤러 대응의 첫 달은 이 세 가지면 충분합니다.